OpenAI 推出了 GPT-6 Cyber,开始向部分 Daybreak Red 客户开放。这款模型专门用于授权安全研究,重点提升漏洞发现、复现和多阶段安全测试能力。
如果你正在用 AI 写代码,我建议先别急着切换。它更适合有明确测试目标和授权范围的安全团队。普通开发者最需要知道的,是它能解决什么问题,以及自己的账号能不能用。
安全团队多了一个专用选择
根据OpenAI 的介绍,GPT-6 Cyber 已经向部分 Daybreak Red 客户开放,后续会逐步扩大范围。
系统卡说明,它基于 GPT-6 Astra,针对漏洞研究等安全任务做了进一步训练,同时强化对用户授权范围的遵守。对安全团队来说,这两部分都影响实际使用。模型需要持续尝试、验证结果,也需要在任务遇到困难时守住约定的边界。
这次发布值得关注的地方,是安全研究有了更专门的工具选择。至于能否缩短团队的工作周期,还要看它在具体项目中找出的结果是否可靠,以及后续验证和修复需要多少人工投入。
长任务进步明显,稳定性还要分别看
安全评估机构 Irregular 与 OpenAI 合作,在三套挑战集上进行了测试,并发布了原始评测报告。
在衡量长程、多阶段任务的 CyScenarioBench 中,GPT-6 Cyber 对 11 个场景都至少成功完成过一次,GPT-6 Astra 完成过其中 8 个。Cyber 的平均成功率为 61%,比 Astra 高 7 个百分点。
这里要分清两个指标。11 个场景都做成过,说明它已经具备完成这些任务的能力;61% 的平均成功率,则提醒我们,同样的工作重复运行时,结果仍然会有差异。如果准备用它承担持续性的安全研究,可靠性和人工复核成本都要算进去。
在另一套面向真实软件与硬件的 FrontierCyber 中,Cyber 完成了 288 项挑战中的 90 项,Astra 完成 96 项。Irregular 提醒,任务存在不同攻击路径,结果也会随运行变化,仅凭总数差异不能认定能力退步。
两款模型都没有成功攻击完全加固的目标,也都没有解决最高难度的 15 项挑战。读到这里,我更看重它在长任务上的进步,而不会把某一项成绩扩展成对所有安全问题的判断。
日常开发,先看自己的任务
OpenAI 在系统卡中明确写道,GPT-6 Cyber 在通用编程评测上没有超过 GPT-6 Astra。这对普通开发者很有参考价值。安全任务上的专门训练,不会自动转化成做页面、改业务功能或整理项目时的全面提升。
如果你主要用 AI 做日常开发,现有模型是否稳定、能否理解项目、修改后是否便于检查,仍然是更直接的选择标准。安全团队则可以把漏洞复现、多阶段测试等工作单独拿出来评估,看看专用模型是否能补上当前流程的短板。
接入门槛也要算进选择里
Daybreak Red 需要身份与资格核验,并设有使用限制。组织还要满足相应的账号和安全要求,API 访问默认要求 IP 白名单。目前获得访问权限的是部分客户,普通订阅账号不能直接据此判断自己已经可以调用。
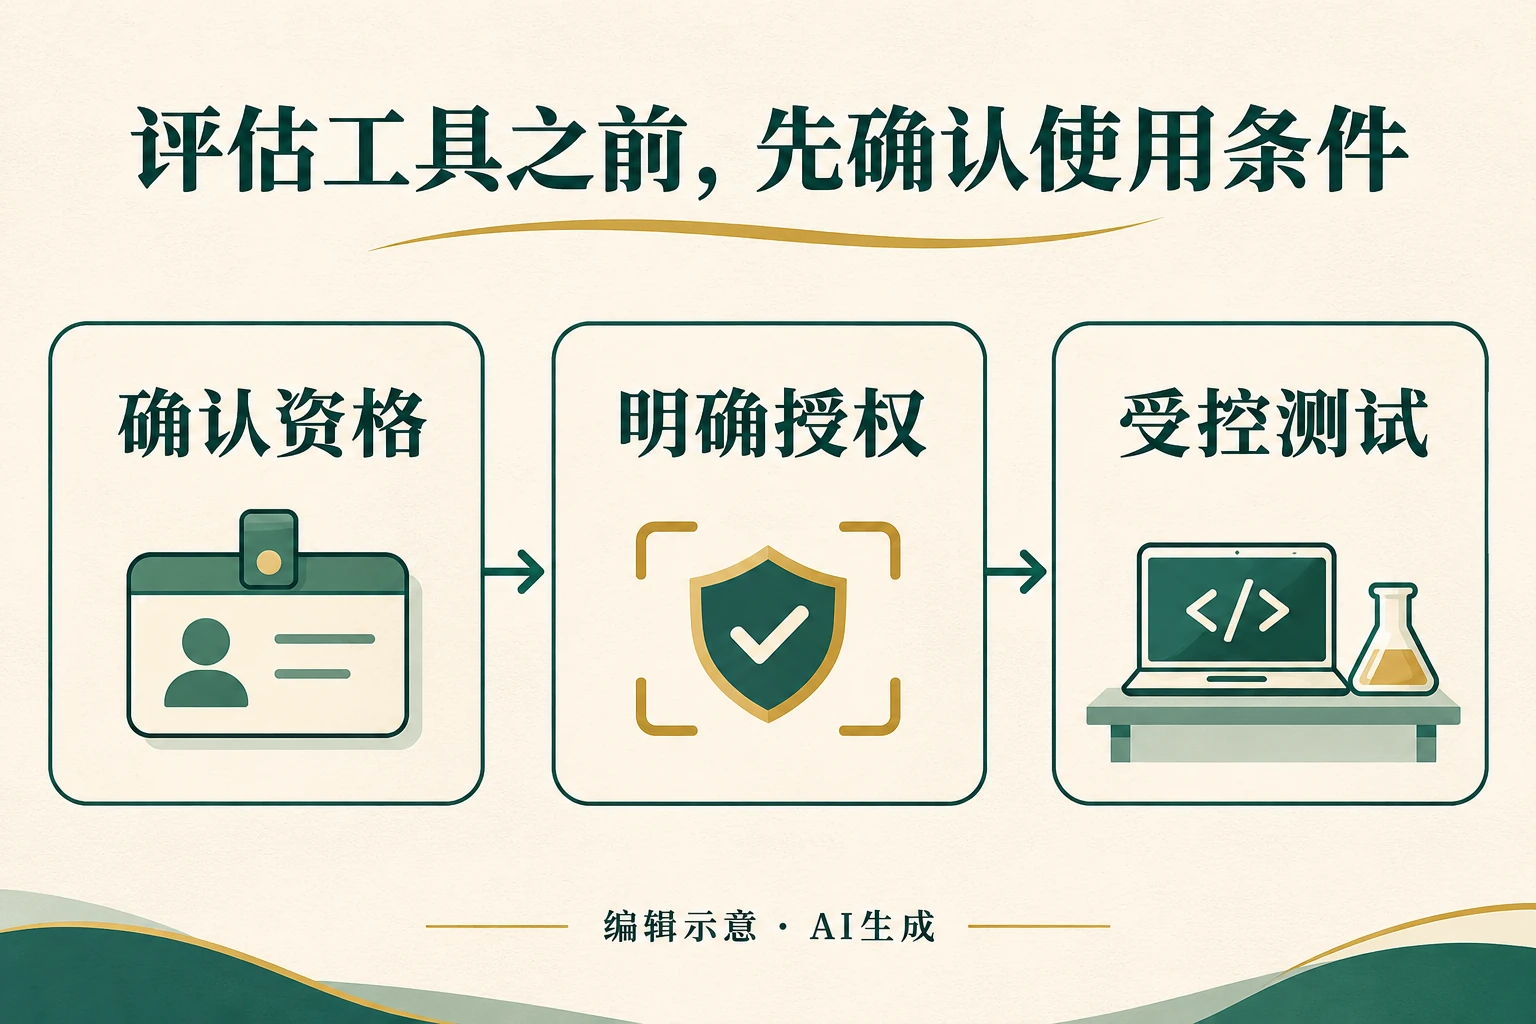
AI 生成示意图。
我会把 GPT-6 Cyber 视为安全团队值得评估的新工具。接入之前,先明确要测试哪些系统、谁有授权、结果由谁复核,再判断模型能节省哪部分工作。对日常写代码的读者,继续围绕自己的任务选工具就好,不必因为多了一个新名字就迁移工作流。


默认评论
Halo系统提供的评论